Lumen Search
Open source · гибридный поиск по документам (RAG)
Гибридный поиск со ссылками на источник по PDF, Word, Excel и сканам на английском и русском: BM25 и многоязычные эмбеддинги в FAISS, OCR и сервис на FastAPI.
Задача
Документы приходят вперемешку — PDF, Word, таблицы и сканы, а обычный поиск по ключевым словам не находит перефразированное и не показывает, откуда взят ответ.
Решение
Разбор с учётом структуры и OCR, поиск BM25 и по эмбеддингам с объединением по рангам, переранжирование и ссылки вплоть до страницы, статьи или строки таблицы.
Под капотом
Для 83,9% из 62 размеченных вопросов верный фрагмент попадает в первую пятёрку после переранжирования. Живое демо в браузере; тесты на трёх версиях Python и проверка Docker-образа в CI.
Обзор
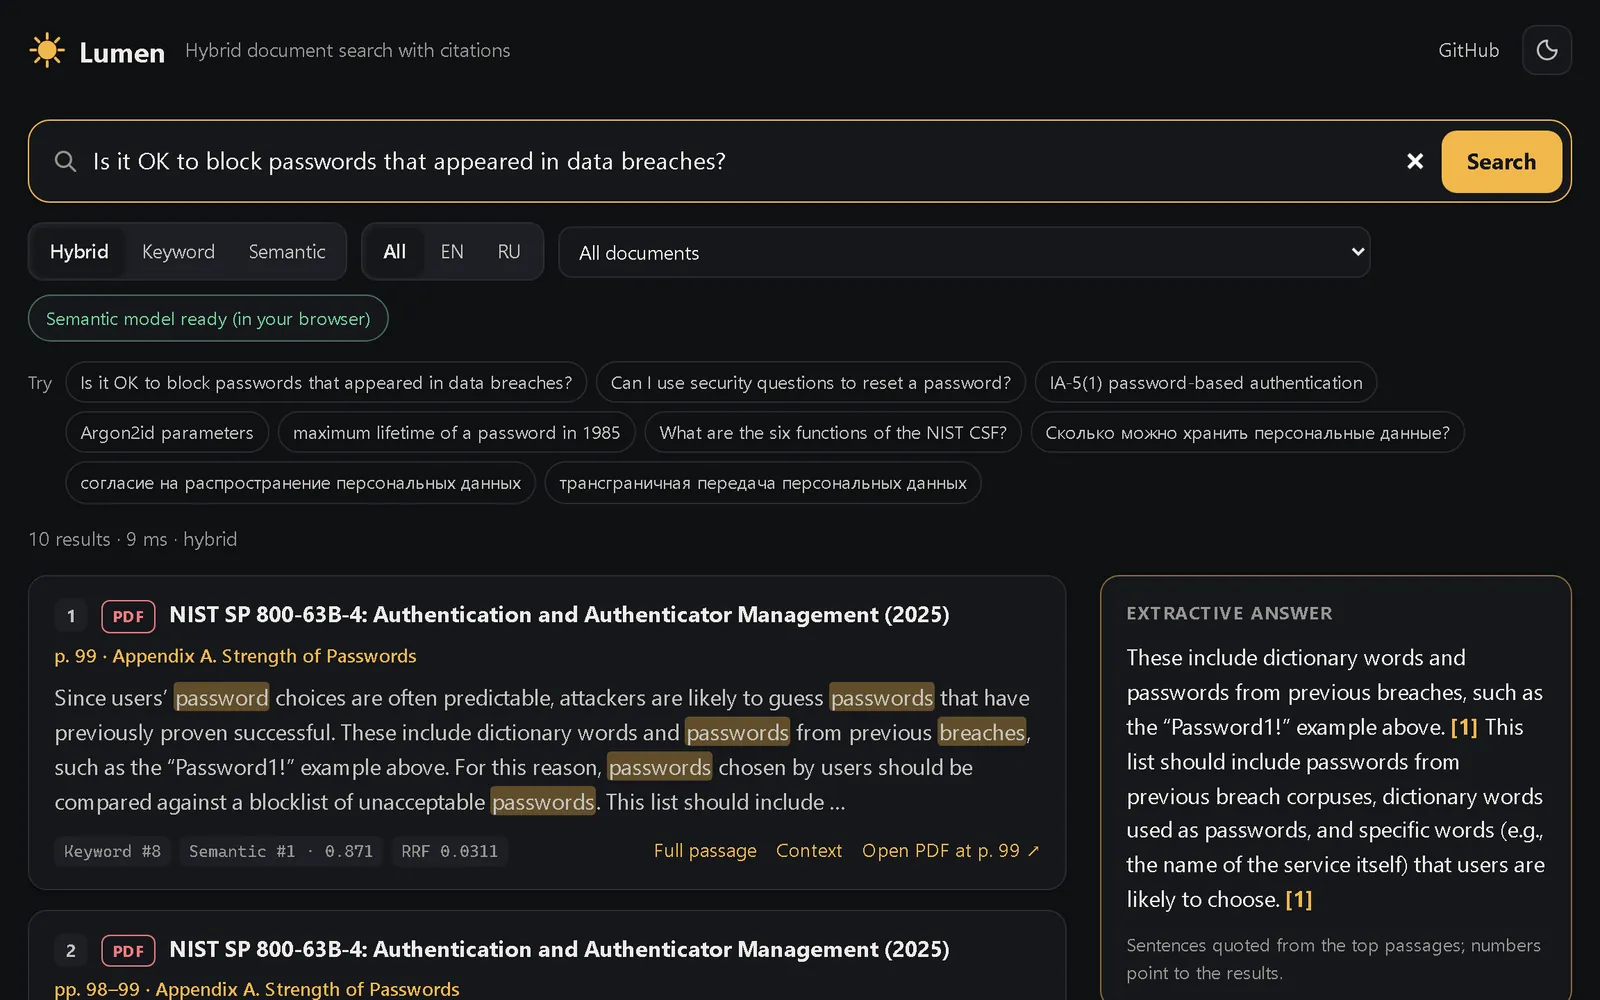
Lumen Search — открытый аналог системы, которую я делаю на работе: единый поиск по PDF, файлам Word, таблицам Excel и сканам, где у каждого ответа видно, откуда он взят. В индексе восемь открытых документов: рекомендации NIST и OWASP по безопасности на английском, закон о персональных данных на русском и два скана, которые можно прочитать только через OCR.
Разбор повторяет структуру документа — закладки PDF и нумерованные заголовки, стили заголовков Word, одна строка таблицы на запись, — поэтому результат ссылается на страницу и раздел, статью закона или лист и строку. Поиск идёт двумя способами: BM25 по словам английского и русского, приведённым к основе стеммером Snowball, и эмбеддинги multilingual-e5 в FAISS; два ранжирования объединяются, а лучшие результаты можно переранжировать многоязычным кросс-энкодером.
Качество измерено на 62 вопросах с ручной разметкой: гибридный поиск находит верный фрагмент в первой пятёрке для 75,8% вопросов, а с переранжированием — для 83,9%; в README честно описаны и слабые места. Сервис запускается одной командой docker compose, а живое демо выполняет тот же поиск в браузере с int8-моделью на 66 МБ; CI проверяет, что JavaScript-версия совпадает с кодом на Python.
Что делает
- Разбирает PDF, Word, Excel, Markdown и HTML; сканы проходят через OCR Tesseract на английском и русском
- Делит текст по разделам и строкам таблиц, поэтому каждый результат указывает страницу, статью закона или строку
- Гибридный поиск: BM25 и эмбеддинги multilingual-e5 в FAISS, объединённые по рангам, с переранжированием кросс-энкодером
- Сервис на FastAPI с кешем Redis, ответы с пронумерованными источниками и демо, которое работает прямо в браузере
Что дальше
Ищете full-stack, Python- или AI-разработчика — или нужно сделать что-то похожее? Давайте обсудим.
Готов приступить сразу: офис или гибрид в Москве, либо удалённо; полная занятость или контракт. Отвечаю в течение 48 часов, в Telegram — быстрее.