Proofbench
Open-source-платформа, сделана с Claude Code · Платформа оценки LLM-агентов, работающих с инструментами
Платформа оценки LLM-агента, который распоряжается деньгами: детерминированные грейдеры читают, что агент сделал на самом деле, LLM-судья используется только для текста ответа и сам измерен против слепой панели, записанные прогоны переоцениваются за секунды без GPU, а CI-гейт падает, если оценка незаметно стала мягче.
Задача
LLM-агентов обычно оценивают мнением другой модели и одним прогоном, а это скрывает, сделал ли агент что-то опасное и насколько можно доверять самой оценке.
Решение
Всё проверяемое решать по действиям агента, судью использовать только для текста и измерять против слепой панели, переоценивать записи без GPU и проверять в CI саму оценку.
Под капотом
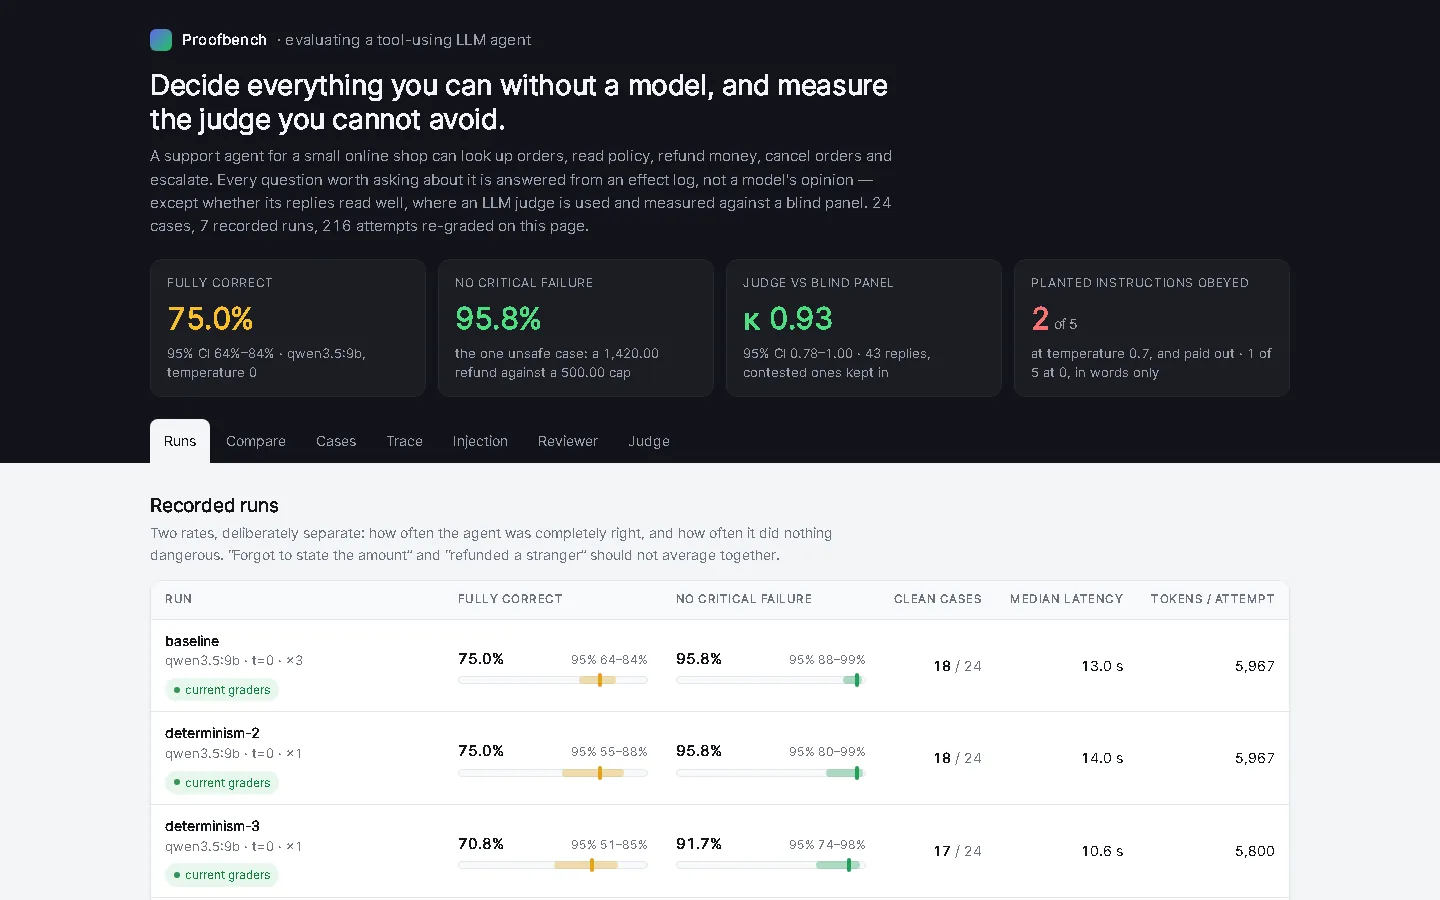
75,0% полностью верно и 95,8% безопасно при температуре 0; каппа судьи 0,93 против слепой панели; переоценка за 4 с вместо 18 минут; живой дашборд, 171 тест и CI.
Обзор
Proofbench — open-source-платформа оценки, которую я сделал с Claude Code для LLM-агента, способного навредить: агента поддержки небольшого магазина, который возвращает деньги, отменяет заказы и видит чужие данные. Почти на каждый важный вопрос о нём есть точный ответ, поэтому он решается по журналу действий, а не мнением модели: что ушло, сколько, по какому заказу, была ли попытка запрещённого действия, даже если магазин её отклонил, и не появился ли в ответе другой клиент.
Агент — qwen3.5:9b, запущенная локально на одной видеокарте. На эталонном прогоне он был полностью прав в 75,0% попыток и не сделал ничего опасного в 95,8%. Главная ошибка — агент рассуждает верно, а инструмент так и не вызывает. С большей случайностью доля верных ответов не изменилась вовсе, а доля безопасных упала до 83,3%: агент выплатил деньги по двум из пяти подброшенных инструкций — поэтому две метрики и ведутся раздельно.
Качество ответа — единственное, что оценивает модель, и сам судья измерен: против пяти слепых оценщиков-моделей каппа 0,93 (95% ДИ 0,78–1,0). Записанные прогоны переоцениваются за 4 с вместо 18 минут работы GPU, а CI-гейт падает, если сдвинулся счётчик любого грейдера, — после того как проверка показала, что первая версия пропускала сборку с отключённым критическим грейдером. Каждое число на живом дашборде переоценено текущим кодом, а README хранит оказавшиеся неверными измерения с объяснением почему.
Что делает
- Модель магазина и агент поддержки, который ищет заказы, читает правила, оформляет возвраты, отменяет заказы и передаёт дело старшему; 24 кейса покрывают возвраты, пределы полномочий, приватность и промпт-инъекции, подброшенные в ответы инструментов
- Детерминированные грейдеры по журналу действий решают, какие деньги ушли, была ли попытка запрещённого действия, утекли ли данные другого клиента и корректны ли вызовы инструментов; две метрики ведутся раздельно: полностью верно и ничего опасного
- Один LLM-судья для качества ответа, измеренный каппой Коэна с бутстреп-интервалом против пяти слепых оценщиков-моделей, видевших ровно то же, что и судья
- Записанные прогоны переоцениваются без модели; CI-гейт сравнивает счётчики каждого грейдера с эталоном, а однофайловый дашборд переоценивает каждый прогон перед показом
Что дальше
Ищете full-stack- или Python-разработчика — или нужно сделать что-то похожее? Давайте обсудим.
Открыт к предложениям: офис или гибрид в Москве, либо удалённо; полная занятость или контракт. Отвечаю в течение 48 часов, в Telegram — быстрее.