Switchyard
Open-source-платформа, сделана с Claude Code · Шлюз перед серверами инференса LLM
Шлюз на Go, только стандартная библиотека, перед серверами инференса LLM: никогда не отправляет реплике больше, чем она может выполнить, отказывает в работе, которую не успеет выполнить, с указанием времени повтора вместо таймаута, и повторяет упавший запрос на другой реплике только пока клиент ещё ничего не получил — измерено на реальной GPU против обычного балансировщика.
Задача
GPU выполняет одновременно лишь несколько запросов; сверх этого обычный балансировщик продолжает пересылать, лишнее невидимо ждёт внутри серверов, и почти каждый пользователь стоит за запросами, которые уже опоздали.
Решение
Держать очередь в шлюзе, не превышать слоты реплики, отказывать сразу, если запрос не успеет к дедлайну, и повторять только пока клиент ничего не получил.
Под капотом
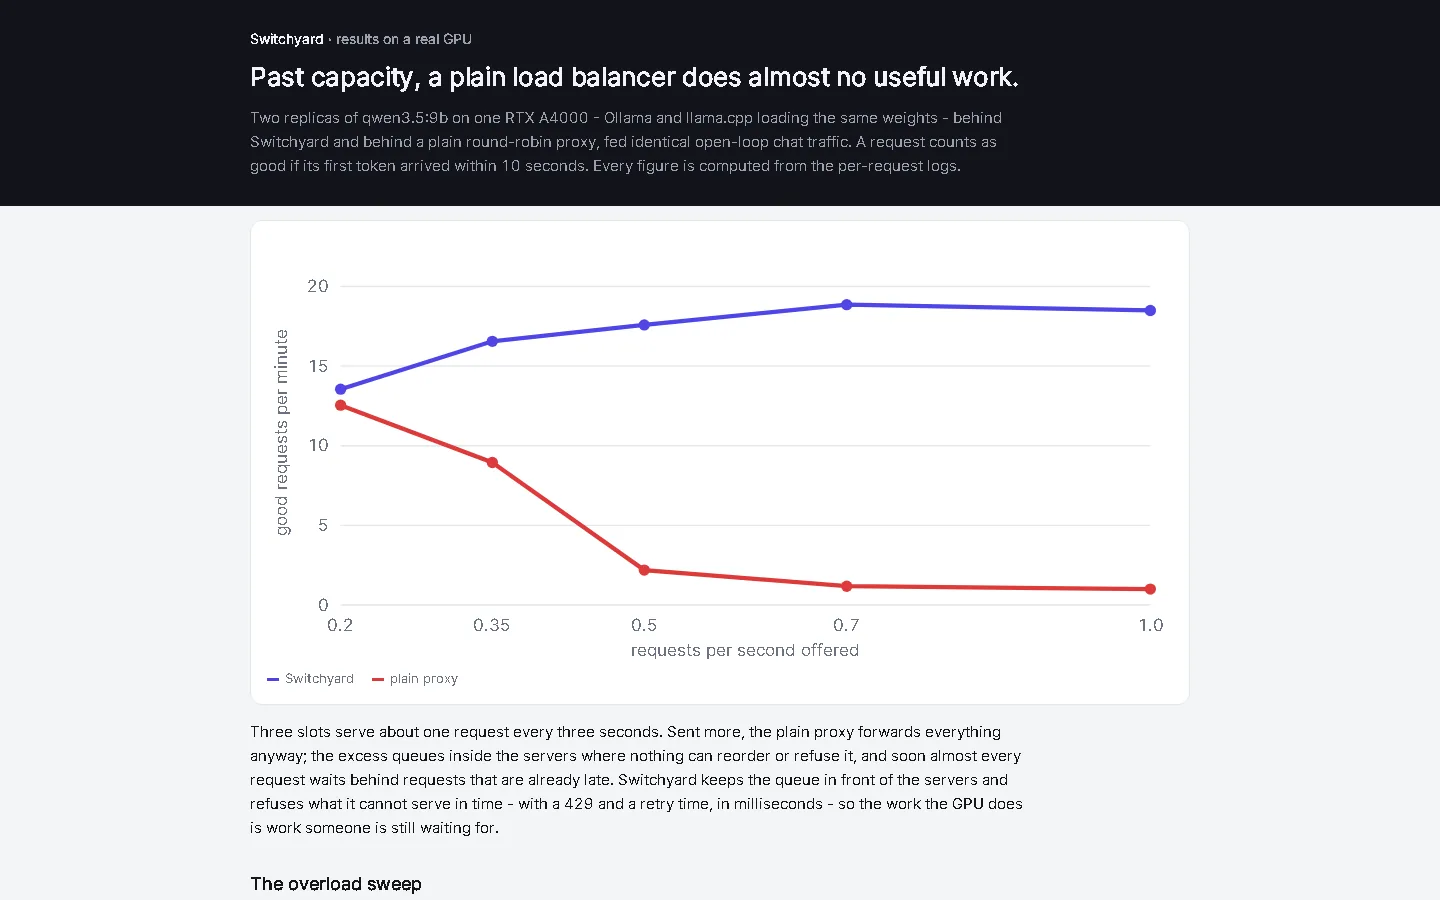
78 из 212 запросов вовремя при 1,0/с против 6 у обычного прокси, ноль сбоев против 150; ни одной ошибки у клиентов при убитой реплике; живой дашборд, 47 тестов и CI.
Обзор
Switchyard — open-source-шлюз, который я сделал с Claude Code для нескольких GPU, обслуживающих многих пользователей. Сервер инференса выполняет одновременно лишь несколько запросов, а остальные ставит в невидимую очередь, где их нельзя ни переупорядочить, ни отклонить; обычный балансировщик равномерно размазывает перегрузку и прячет её везде. Switchyard держит очередь перед серверами, отправляет каждой реплике не больше запросов, чем у неё слотов, и отказывает в том, что не успеет выполнить, с указанием времени повтора. Написан на Go без зависимостей вне стандартной библиотеки.
Измерено на одной RTX A4000 с qwen3.5:9b на двух репликах — Ollama и llama.cpp на одних весах — против обычного round-robin-прокси при одинаковом открытом потоке чат-запросов: при 1,0 запроса в секунду прокси дал первый токен за 10 секунд 6 запросам из 212, а 150 упали; Switchyard — 78, ни одного сбоя, остальным отказал не дольше чем за 3 мс. При убитой под нагрузкой реплике прокси вернул клиентам 15 ошибок, Switchyard — ни одной, дообслужив 7 затронутых запросов на живой реплике. Возврат диалога к его кэшу на этом масштабе измеримого эффекта не дал, и это так и написано.
Первый прогон стенда нашёл в шлюзе три ошибки, и все занижали его результат, а запуск второй реплики на GPU вскрыл взаимодействие Docker и NVIDIA, которое незаметно перевело модель другого сервиса на CPU; всё исправлено и описано. Живой дашборд и страница результатов на реальной GPU открыты, а каждая таблица пересчитывается из сырых логов в репозитории.
Что делает
- Держит очередь перед серверами, а не внутри них, упорядочивает по приоритету и отказывает запросу сразу, если ожидание дольше его дедлайна: 429 с Retry-After за миллисекунды вместо таймаута через минуту
- Повторяет упавший или зависший запрос на другой реплике только до первого байта клиенту; поток, оборвавшийся на середине ответа, завершается событием об ошибке, а не склейкой с текстом другой модели
- Возвращает диалог на реплику, хранящую его кэш промпта, лимитирует ключи API по токенам и запросам и выводит сбоящую реплику из ротации автоматическим выключателем с пробными запросами
- Живой дашборд, который отдаёт сам шлюз, метрики Prometheus, симулятор сервера инференса для тестов без GPU и стенд, где каждая таблица пересчитывается из сырых логов запросов
Что дальше
Ищете full-stack- или Python-разработчика — или нужно сделать что-то похожее? Давайте обсудим.
Открыт к предложениям: офис или гибрид в Москве, либо удалённо; полная занятость или контракт. Отвечаю в течение 48 часов, в Telegram — быстрее.