Поиск по технической документации
Python-разработчик · апрель–октябрь 2026 · семантический и полнотекстовый поиск
Семантический и полнотекстовый поиск по архиву документации ПТО — около 4,1 тыс. файлов PDF, DOCX, XLSX и RTF: собственный инвертированный индекс плюс FAISS на sentence-transformers, сервис на FastAPI. Без генерации LLM.
Загрузка
Индекс
Запрос
Задача
Инженеры искали по сетевому архиву PDF, Word, Excel, RTF и сканов вручную. Обозначения — марки кабелей, шифры — должны совпадать точно, а фразам нужен поиск по смыслу.
Решение
Собственный инвертированный индекс для точных обозначений плюс семантический поиск FAISS, OCR для сканов и метки надёжности у каждого результата; бэкенд на FastAPI, интерфейс на HTML/JS, служба systemd.
Результат
Принято заказчиком в сентябре 2026 года: p95 — 0,18 с, 739 тестов и контрольный набор из 104 запросов.
Обзор
Документация ПТО «Электросервиса» хранится в сетевом архиве: около 4,1 тыс. файлов PDF, DOCX, XLSX и RTF, из них около 1,5 тыс. — с текстом. С апреля по октябрь 2026 года по договорам ГПХ я сделал сервис поиска по нему: инженер вводит марку кабеля, шифр, обозначение оборудования или фразу и получает документ, страницу PDF (лист и строки Excel, раздел Word), фрагмент текста и сетевой путь. Документы не покидают сеть компании.
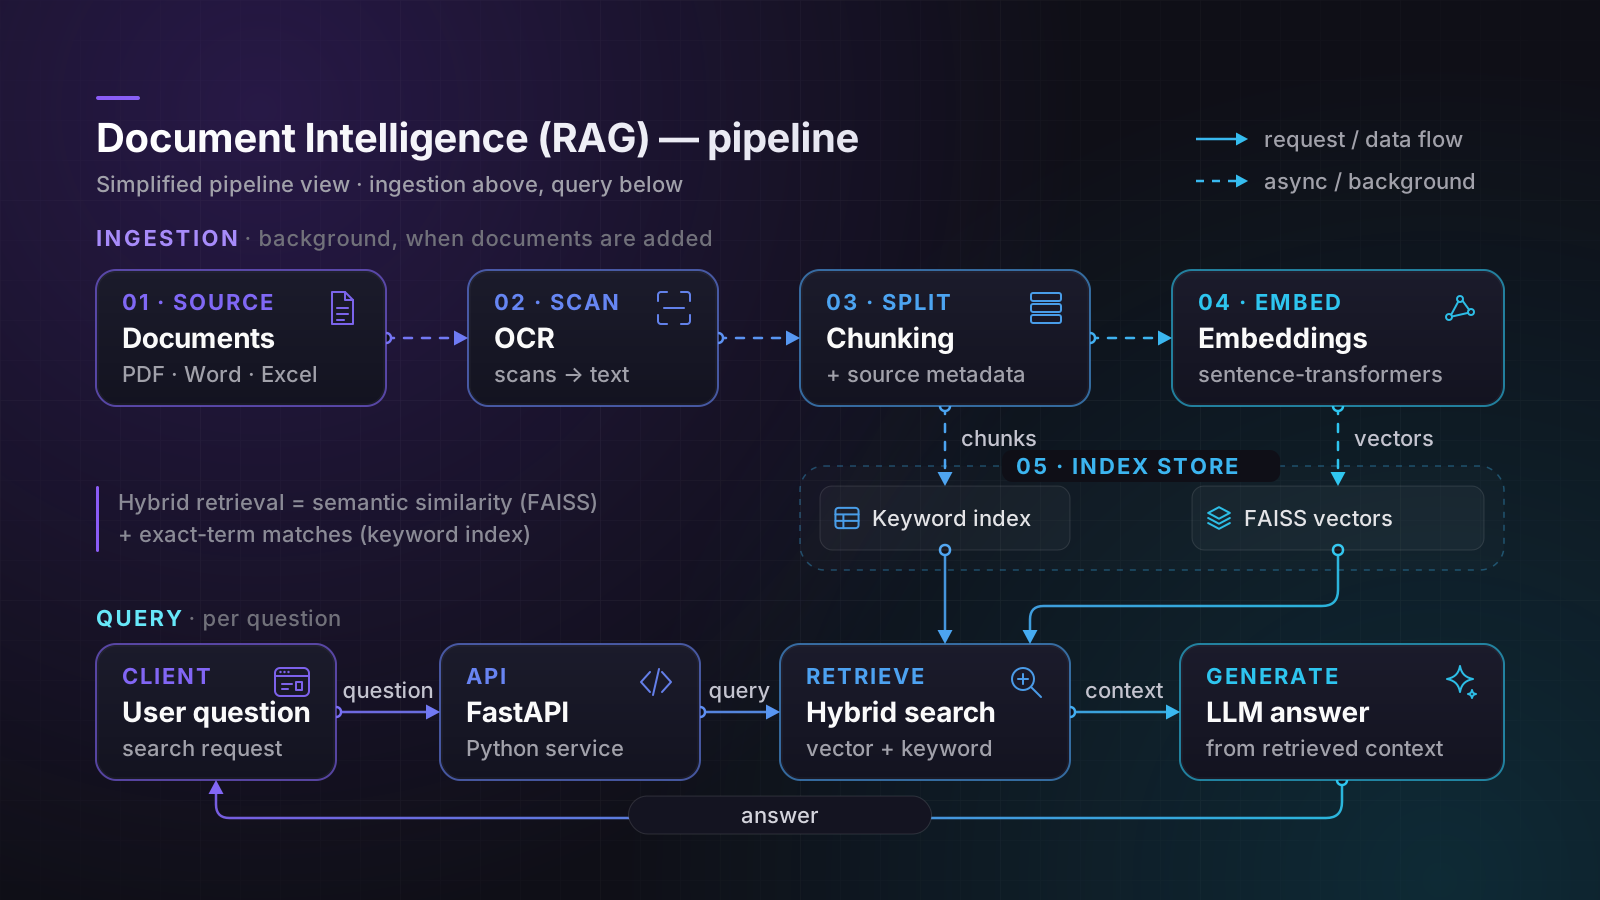
Поиск гибридный, без генерации LLM: собственный инвертированный индекс по словам и обозначениям плюс семантический поиск FAISS на эмбеддингах sentence-transformers (all-MiniLM-L6-v2). Обозначения сравниваются по общим правилам: латиница и кириллица одинакового начертания, пробелы и дефисы не мешают совпадению, а номера и марки не подменяются. Сканы определяются автоматически, выбранные страницы проходят OCR (Tesseract + Poppler). Бэкенд — FastAPI, интерфейс — HTML/JS без фреймворков; сервис работает как служба systemd на Ubuntu Server с атомарной заменой индекса и откатом.
Запросы по шифрам и маркам ускорились с 9–10 с до 1,2–1,7 с, фразовые — с 55–70 с до 2–4 с; после перехода на инвертированный индекс p95 — 0,18 с на 55 контрольных запросах. Качество держат 739 тестов pytest и контрольный набор из 104 запросов с метриками top-1/top-5. Делал с AI-агентами (Codex, Cursor, Claude Code): собирал требования, писал ТЗ для агентов, ревьюил изменения и проверял их на рабочем индексе. Работа принята заказчиком в сентябре 2026 года. Код закрыт, поэтому здесь показана схема архитектуры.
Что делает
- Находит марку кабеля, шифр, обозначение оборудования или фразу и возвращает документ, страницу (или лист и строки), фрагмент и сетевой путь
- Гибридный поиск: собственный инвертированный индекс плюс семантический поиск FAISS на sentence-transformers (all-MiniLM-L6-v2)
- Сканы определяются автоматически; выбранные страницы проходят OCR (Tesseract + Poppler)
- Метки надёжности — «Точное совпадение», «Требуется проверка», «Совпадает частично» — и один результат на документ
Что дальше
Ищете full-stack- или Python-разработчика — или нужно сделать что-то похожее? Давайте обсудим.
Открыт к предложениям: офис или гибрид в Москве, либо удалённо; полная занятость или контракт. Отвечаю в течение 48 часов, в Telegram — быстрее.