Switchyard
منصة مفتوحة المصدر، بُنيت باستخدام Claude Code · بوابة أمام خوادم استدلال النماذج اللغوية
بوابة بلغة Go بالمكتبة القياسية وحدها، تقف أمام خوادم استدلال النماذج اللغوية: لا ترسل إلى أي نسخة أكثر مما تستطيع تشغيله، وترفض العمل الذي لن تنجزه في وقته مع موعد لإعادة المحاولة بدل انتهاء المهلة، ولا تعيد الطلب الفاشل على نسخة أخرى إلا ما دام العميل لم يتلقَّ شيئاً — مَقيسة على GPU حقيقية مقابل موزّع أحمال عادي.
المشكلة
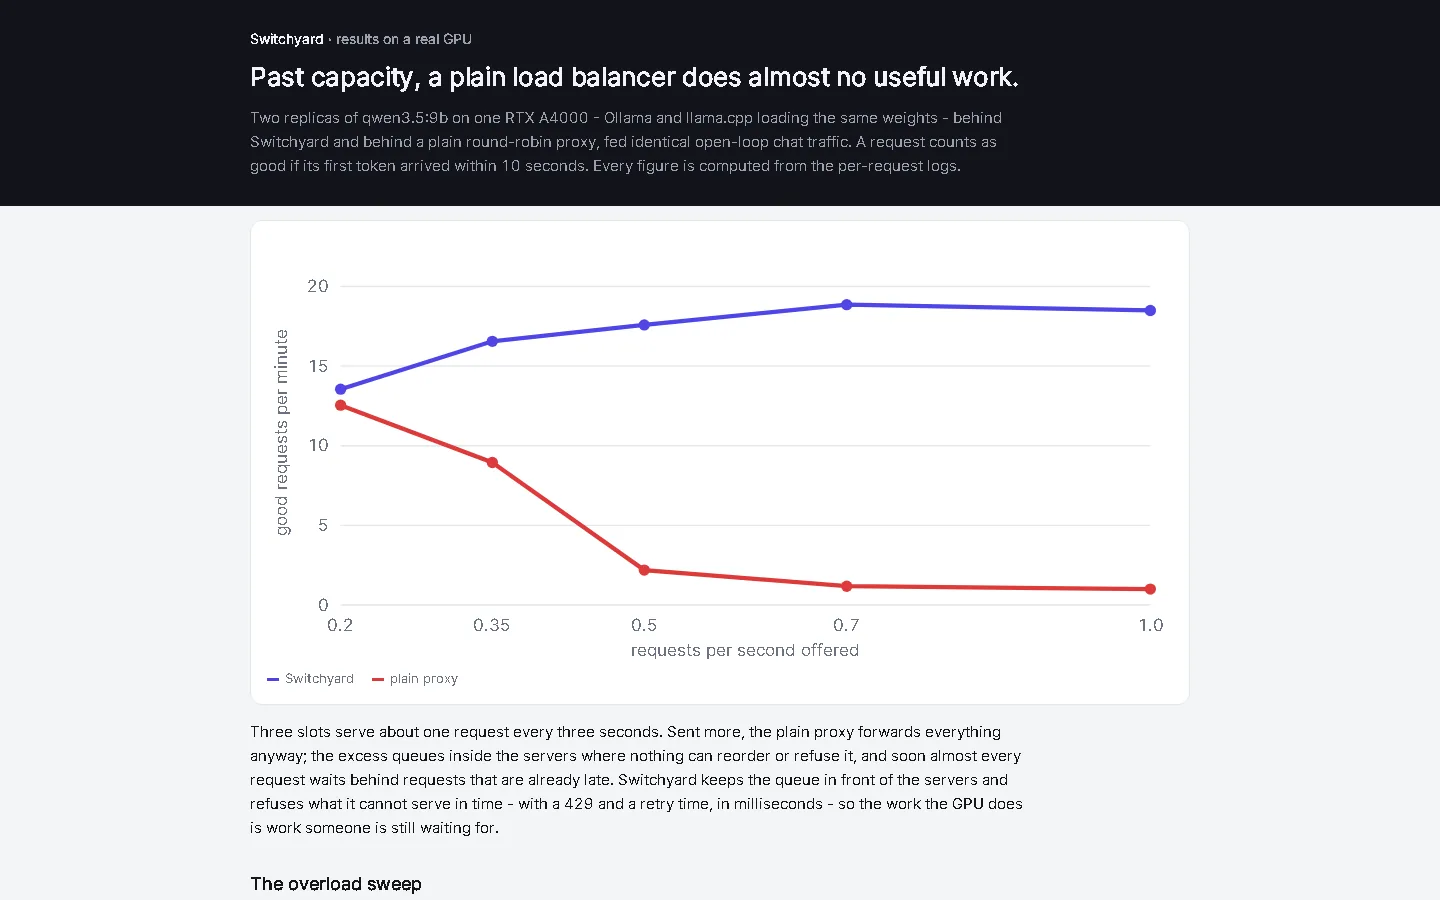
لا تشغّل بطاقة GPU إلا طلبات قليلة في آن واحد؛ وبعد ذلك يواصل موزّع الأحمال العادي التمرير، فينتظر الفائض خفياً داخل الخوادم، وينتهي كل مستخدم تقريباً خلف طلبات متأخرة أصلاً.
الحل
إبقاء الطابور في البوابة، وعدم تجاوز خانات أي نسخة، والرفض فوراً إن كان الطلب سيتجاوز مهلته، وإعادة المحاولة فقط ما دام العميل لم يتلقَّ شيئاً.
التفاصيل التقنية
78 من 212 طلباً في الوقت عند طلب/ث مقابل 6 للوكيل العادي، ولا فشل مقابل 150؛ لا أخطاء للعملاء مع إيقاف نسخة؛ لوحة حية و47 اختباراً وتكامل مستمر.
نظرة عامة
Switchyard بوابة مفتوحة المصدر بنيتُها باستخدام Claude Code لبضع بطاقات GPU تخدم مستخدمين كثيرين. لا يشغّل خادم الاستدلال إلا طلبات قليلة في آن واحد ويضع الباقي في طابور خفي لا يمكن فيه إعادة ترتيبها ولا رفضها؛ أما موزّع الأحمال العادي فيوزّع الضغط بالتساوي ويخفيه في كل مكان. تُبقي Switchyard الطابور أمام الخوادم، ولا ترسل إلى كل نسخة أكثر من عدد خاناتها، وترفض ما لن تنجزه في وقته مع موعد لإعادة المحاولة. وهي مكتوبة بلغة Go دون أي اعتماد خارج المكتبة القياسية.
قيست على بطاقة RTX A4000 واحدة تشغّل qwen3.5:9b عبر نسختين — Ollama وllama.cpp على الأوزان نفسها — مقابل وكيل round-robin عادي يتلقى حركة محادثات مفتوحة متطابقة: عند طلب واحد في الثانية أوصل الوكيل أول رمز خلال 10 ثوانٍ إلى 6 طلبات من 212 وفشل 150؛ وأوصلته Switchyard إلى 78 دون أي فشل، ورفضت الباقي خلال 3 أجزاء من الألف من الثانية على الأكثر. وحين أُوقفت نسخة تحت الحمل أعاد الوكيل 15 خطأ إلى العملاء ولم تُعِد Switchyard أي خطأ، وأكملت 7 من الطلبات المتأثرة على النسخة السليمة. أما إعادة المحادثة إلى ذاكرتها المؤقتة فلم يظهر لها أثر قابل للقياس على هذا الحجم، وقد كُتب ذلك كما هو.
كشف أول تشغيل للقياس ثلاثة أخطاء في البوابة كلها تُظهرها أسوأ مما هي، وكشف تشغيل النسخة الثانية على GPU تفاعلاً بين Docker وNVIDIA نقل نموذج خدمة أخرى إلى المعالج دون أي إنذار؛ وكلها أُصلحت ووُثّقت. اللوحة الحية وصفحة نتائج GPU الحقيقية متاحتان للجميع، وكل جدول يُعاد حسابه من السجلات الخام في المستودع.
ماذا يفعل
- تُبقي الطابور أمام الخوادم لا داخلها، مرتباً حسب الأولوية، وترفض الطلب فوراً إذا كان انتظاره المتوقع أطول من مهلته: 429 مع Retry-After خلال أجزاء من الثانية بدل انتهاء المهلة بعد دقيقة
- تعيد الطلب الفاشل أو العالق على نسخة أخرى فقط قبل وصول أول بايت إلى العميل؛ والبث الذي ينقطع في منتصف الإجابة ينتهي بحدث خطأ لا بنص نموذج آخر ملصوق به
- تعيد المحادثة إلى النسخة التي تحتفظ بذاكرة موجّهاتها المؤقتة، وتحدّ مفاتيح API بالرموز والطلبات معاً، وتُخرج النسخة المتعثرة من التدوير بقاطع دائرة يختبر عودتها
- لوحة حية تقدمها البوابة نفسها، ومقاييس Prometheus، ومحاكي لخادم الاستدلال لاختبارات بلا GPU، ومنصة قياس تُعاد كل جداولها من السجلات الخام لكل طلب
الخطوة التالية
تبحث عن مطوّر Full-Stack أو Python — أو تحتاج إلى بناء شيء مشابه؟ لنتحدث.
منفتح على عروض العمل — حضورياً أو بنظام هجين في موسكو، أو عن بُعد؛ بدوام كامل أو بعقد. أردّ خلال 48 ساعة — وأسرع عبر Telegram.